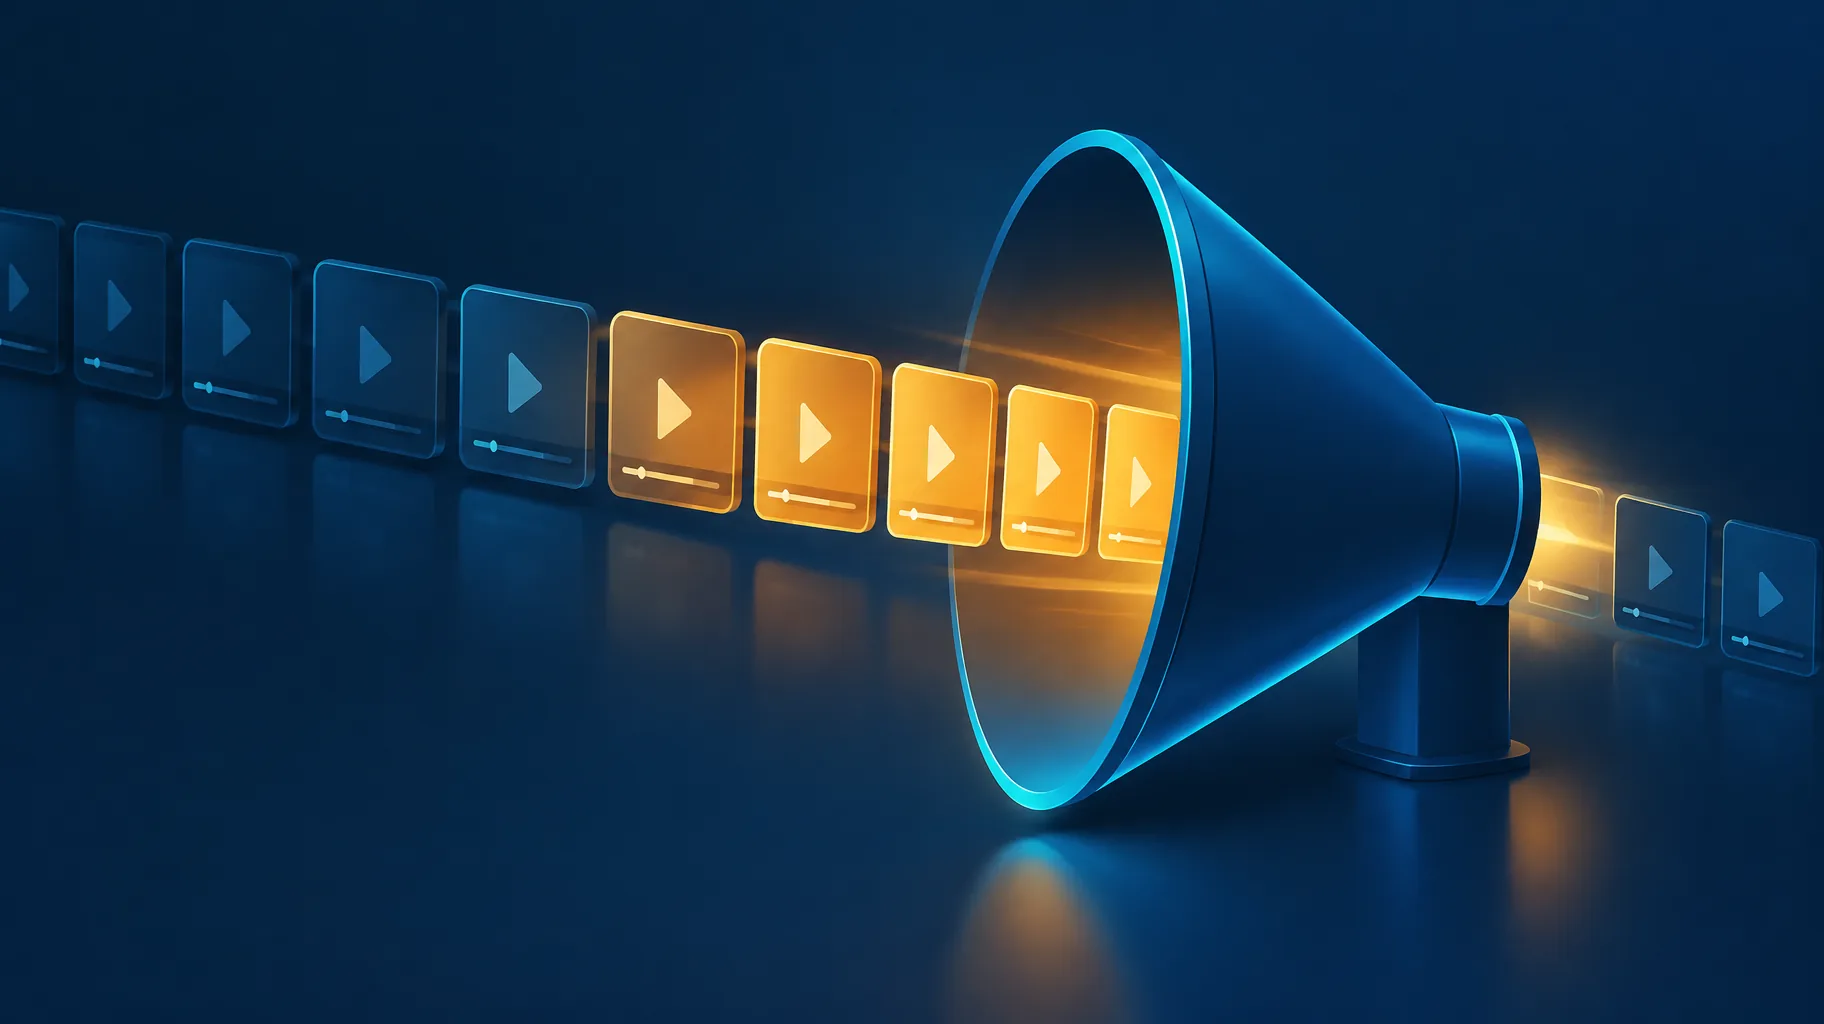
AI 视频批量生成之所以会排队,是因为提交任务和运行任务是两个独立步骤:服务商会一次性接收整批任务,但并发限制决定了同时生成的任务数量上限。超出上限的请求会进入 THROTTLED 状态并排队等待,因此,一批 50 个视频会分批完成,而不是全部同时生成。
核心要点:
- 根据 Runway 的使用等级文档,其 API 的 Tier 3 等级允许同时运行五个任务,每月消费上限为 2,000 美元;累计购买金额达到 100 美元后,即可立即升至该等级。
- 超出适用并发上限的请求会进入 THROTTLED 状态,等待处理,而不是直接失败。
- 系统负载较高时,实际并发量偶尔会低于公布的最大值,因此文档中的上限并不等于吞吐量保证。
- 购买更多 API 额度可以增加可消费金额,但不会直接提高决定整批任务完成速度的并发上限。
批量提交和并发生成有什么区别?
批量提交是指通过一次调用或脚本循环发送多个生成请求;并发生成则是指服务商同时处理其中多少个请求。两者相互独立。Runway 的 API 会立即接收整批任务,但只会在你所属等级的并发上限内,让任务进入实际处理阶段。根据 Runway 的使用等级文档,Tier 3 的并发上限为五个任务,每月消费上限为 2,000 美元,累计购买金额达到 100 美元后即可立即升至该等级。因此,上午 9 点提交一批 40 个视频后,实际情况是五个视频正在生成、35 个正在等待,而不是 40 个视频同时生成。
这个区别很重要,因为大多数交付时间估算都错在这里。创作者测出生成一个视频需要多久,却不考虑批次数量,就以为整批视频也能在差不多的时间内完成。正确的理解方式是把它看成一个队列:总耗时约等于批次数量除以并发数,再乘以单个任务的平均耗时,最后还要考虑时间波动。
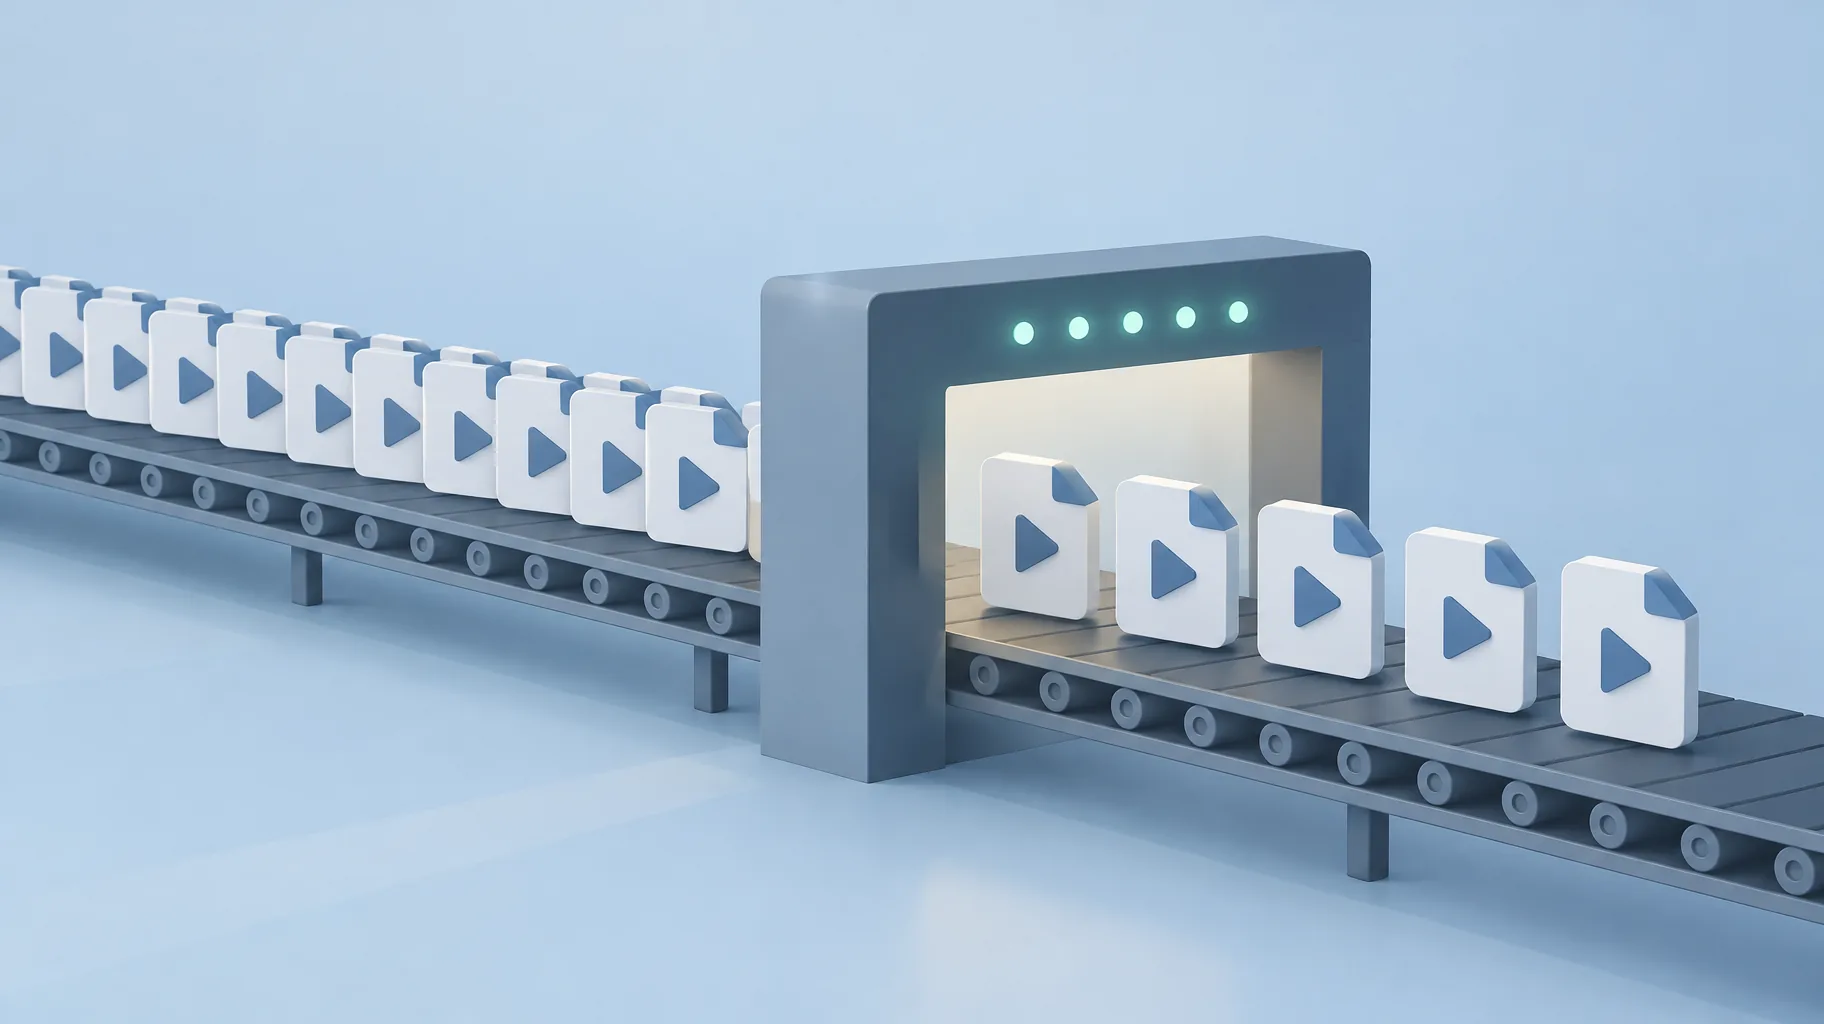
AI 视频 API 中的 THROTTLED 是什么意思?
THROTTLED 是一种排队状态,不是错误。Runway 在其使用等级页面中说明,超出适用并发上限的请求会进入 THROTTLED 状态并等待处理。被限流的任务已经被接收,只是暂时等待;一旦有并发名额空出,就会进入实际生成阶段。你的批量任务没有出问题,只是在排队。
实际操作时要注意:不要重试或重新提交处于 THROTTLED 状态的任务。重新提交会产生重复请求,而且新副本可能被排到队尾,原任务却仍占着原来的位置。轮询任务状态,耐心等待,让队列逐步处理完即可。
消费额度还有剩余,也可能触及并发限制吗?
会,因为消费上限和并发上限是两种独立的约束,限制的是不同的事情。根据 Runway 的使用等级文档,Tier 3 的每月消费上限为 2,000 美元,并发上限为五个任务。消费上限决定你一个月最多能花多少钱;并发上限决定同一时间能运行多少个任务。即使你还剩 1,900 美元的可用消费空间,第六个任务也可能一直处于 THROTTLED 状态,等待正在运行的五个任务释放名额。
Concurrency and budget are independent limits; headroom in one does not lift the other.
| Runway API Tier 3: two separate ceilings | |
|---|---|
| Concurrent tasks | 5 |
| Monthly spending cap (US$) | 2,000 |
| Spend to reach tier (US$) | 100 |
购买更多 API 额度,一定能让整批任务更快完成吗?
不一定。购买额度会增加可消费金额,在某些等级下,也能解锁并发上限更高的等级,但额度本身不会让处理通道变宽。Runway 在其使用等级页面中指出,受系统负载影响,实际并发量偶尔会低于公布的最大值,而且其假设性的处理时间计算并不是基于实测的完成时间保证。即使你已付费达到相应等级,整批任务的处理速度仍可能慢于按文档上限推算的结果。
应当把并发数看作最佳情况下的数值,而不是服务水平承诺。如果你要按时向客户交付,就必须依赖系统连续六小时维持公布的最大并发量,那么这份计划就没有为服务商自己也提醒过的降速情况留下任何余地。
处理时间不稳定时,应该如何估算整批任务的完成时间?
用排队模型估算,再额外留出余量。公式是:预计整批耗时等于视频数量除以并发数,再乘以实测的单个视频平均耗时,最后乘以 1.5 到 2 的安全系数,以应对系统负载造成的降速和生成失败。
举个例子:要制作 30 个 Shorts 视频,有五个并发名额,实测每个视频平均耗时四分钟。简单估算是 (30 / 5) x 4 = 24 分钟。加入余量后的计划耗时是 24 x 1.5 = 36 分钟,而你对外承诺 48 分钟后交付。如果整批任务在 26 分钟内完成,你没有任何损失;如果系统负载导致有效并发量减半,你仍然可以按时交付。将单个视频耗时纳入制作记录的创作者,可以在每批任务完成后更新平均值,而不是凭空猜测。
安排大批量任务前,小规模测试应该测量什么?
先试跑一批五到十个视频,记录四项数据:从提交到开始处理的等待时间、单个视频的生成时间、整批任务从头到尾的实际总耗时,以及失败或重试次数。这些数据能让你得到实测的平均值和波动程度,用自己的数据替代服务商提供的假设性耗时示例。Adobe 对其可重复执行的 Firefly Graph 工作流也给出了相同建议:扩大规模前,先用最少的输入进行测试,因为费用和运行表现可能随执行情况而变化。
具体行动: 在你计划运行正式批量任务的同一时段提交测试批次,因为系统负载会随时段变化。
所需准备: 为每个任务记录时间戳,用脚本或电子表格都可以完成。
如何判断有效: 第一次完整运行时,实际整批耗时落在你按安全系数预留的时间范围内。
引入编排层可以让这套流程重复执行。GoFaceless(我们自己的产品)可以根据一个主题或简要需求,一次完成从脚本到字幕的整个流程,产出短视频成片,适合准备标准化、可重复执行的任务;但底层生成服务商仍然可能设置队列和并发限制,因此无论采用哪种方式,上述测量方法都适用。如果你也在考虑应该如何提交任务,AI 配音 API 与网页应用对比中讨论的取舍,同样适用于视频批量任务。
唯一原则:按队列安排时间,不要按上限安排
文档中的并发限制只是同时处理任务数量的上限,并不是吞吐量承诺。先用小批量测试测出自己的完成时间,再用队列模型估算整批耗时,并在承诺交付时间前乘以安全系数。这样做的创作者很少错过截止时间;而那些以为整批任务只需一个视频的生成时间的人,反倒总会如期延误。
如果你希望有人代劳前期准备,GoFaceless 可以将一个主题转化为完整的不露脸视频,涵盖脚本、配音、画面和字幕,让你的批量任务从一开始就保持标准化。查看套餐与价格,选择适合你批量制作规模的方案。