无脸 YouTube 视频的创建,利用 AI 需要大约 20 分钟到 3 小时,前提是创作者已经拥有模板和自动化工作流程,但第一部视频通常需要 6-12 小时。这种差异来自于仍需手动完成的工作量:在使用分开的工具和决策时,研究、编剧、寻找视觉素材、配音设置、编辑和质量控制都需要时间。
关键要点:
- 根据 Stitchr 的无脸视频时间基准,第一部无脸 YouTube 视频可能需要 6-12 小时。
- 同样的 Stitchr 基准 估计,对于已熟悉该过程的创作者,所需时间为 2-3 小时。
- 根据 Stitchr,自动化的无脸视频工作流程可以将完成的视频缩短至约 20 分钟。
- 基于经验的系统化生产工作流程可以达到 2 小时每个视频,如同在这篇 工作流程指南 中所记录。
影响制作无脸视频时间的因素有哪些?
制作无脸视频所需的时间主要取决于主题的复杂性、视频长度、视觉需求、修改标准以及创作者是否使用可重复的资产。第一部视频可能需要 6-12 小时,因为创作者也在建立一个过程,而有经验的创作者在重复决策(如叙述风格、字幕和场景格式)已经定义后,能达到 2-3 小时 根据 Stitchr 的基准。
研究密集型的主题所需时间超出清单、评论或简单解释类视频,因为每一项事实声明都需要审核。需要原创图表、产品演示或精确匹配视觉效果的视频,也需要比基于已有视觉模式构建的视频更多的手动指导。
视频长度是一个因素,但并不是唯一的驱动因素。一个 45 秒的短视频如果主题难度较大,可能比一个遵循成熟格式的五分钟视频耗时更长。计算决策,而不仅仅是真实播放时间。
计划额外时间的情况:
- 主题需要事实核查或来源审核。
- 脚本需要独特视角,而不是熟悉的格式。
- 每个场景需要独特的视觉素材。
- 视频采用新的声音、字幕风格或编辑模板。
常见误解:无脸视频并不自动生成快速。去掉在镜头前的拍摄虽然省去拍摄工作,但并不消除创意判断或审核的需要。
AI 能否节省视频制作的时间?
AI 可以通过减少从构思、编剧、配音、视觉选择、字幕到组装的手动交接,来节省制作无脸视频的时间。最大限度的时间节省来源于将这些阶段连接成一个可重复的序列,而不仅仅是生成一个脚本。Stitchr 报告称,自动化能将无脸视频缩短至约 20 分钟,与初次尝试时的 6-12 小时 对比 在其发布的基准中。
AI 最实用的地方在于能快速生成可用的初稿。它可以将清晰的简报转换成脚本结构、叙述、场景建议、字幕和可编辑的时间线。然后创作者应将节省出来的时间花在影响观众反应的部分:开场引子、事实准确性、节奏、视觉相关性以及最终润色。
AI 无法消除对编辑标准的需求。一个薄弱的主题在自动化制作后仍然是薄弱的。除非创作者提供明确的受众、角度和格式,否则通用的脚本也可能产生通用的视觉效果和节奏。
在主题选择方面,要从窄小的受众问题开始,而不是广泛的类别。一个免费的 无脸视频主题创意工具 可以帮助将细分市场转化为更容易编写和持续制作的具体概念。
AI 和传统方法之间的时间差异是什么?
AI 辅助与传统无脸制作之间的实际时间差异在于创作者必须协调的手动制作步骤数量。根据 Stitchr 的制作时间范围,第一部无脸视频可能需要 6-12 小时,一个经验丰富的可重复工作流程可能需要 2-3 小时,而一个自动化工作流程可能仅需约 20 分钟。这些数字同样描述了流程的成熟度和工具的选择。
一个传统的多工具工作流程通常意味着在一个地方写作,在其他地方录制或生成叙述,寻找视觉素材,在时间线上编辑场景,添加字幕,然后导出。每次交接都会增加设置时间和修改机会。AI 辅助制作通过从相同的简报生成连接的草稿素材,从而压缩这些交接。
该图表是一个规划范围,而不是承诺。20 分钟的结果假设已有准备好的格式和有限的修改。手动指导的纪录片、教育课程或品牌敏感视频可能确实需要更多时间,因检查质量是工作的一个部分。
AI 制作适用于所有类型的视频吗?
AI 制作适用于可重复的无脸格式,例如解释视频、列表视频、新闻风格摘要、简单的教育短视频和重复系列,但并不适用于每种视频。AI 辅助制作在创作者可以在生成前定义受众、角度、脚本模式、声音风格和视觉规则时工作最快。经过经验积累的系统化工作流可以达到 2 小时,但复杂的视频仍然需要人工审核 根据这份记录的工作流程。
对敏感主题、详细的技术指导、原创报道、法律或财务声明以及需要高度特定品牌声音的视频,则应更多地使用手动指导。在这些情况下,AI 仍能够帮助初稿和组装,但不应做未经审核的编辑决策。
好的测试方式很简单:你能将格式描述为可重复的简报吗?如果可以,自动化可能有所帮助。如果每集都需要新的研究、定制的视觉叙事或专家解读,则应利用 AI 协助,而非完全自动化。
使用 AI 的创作者也应了解高效制作和低效输出之间的区别。原创框架、有意义的叙述和刻意的编辑对于想要赢得持久观众信任的频道至关重要。在扩大高度重复的格式之前,请阅读 什么被视为 YouTube 上的不真实内容。
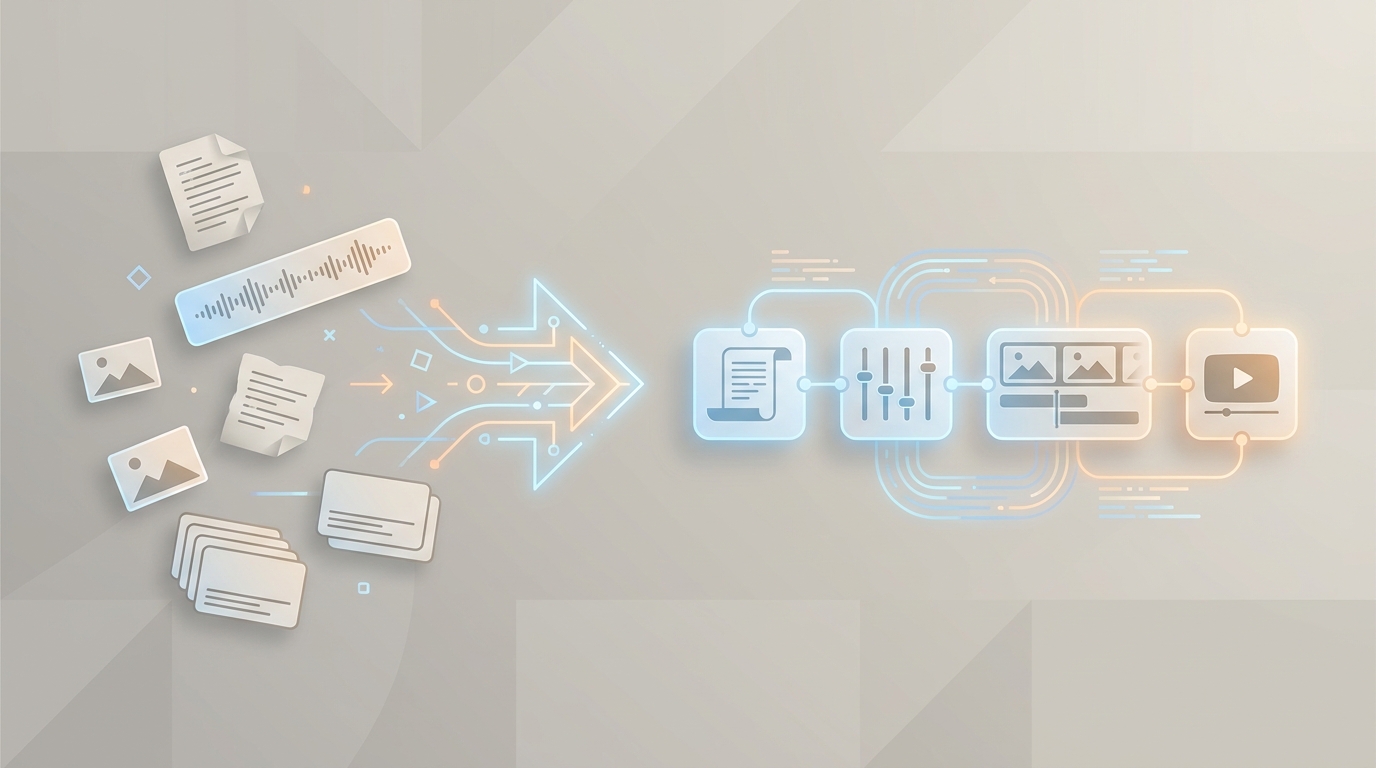
经验和模板如何减少视频创建时间?
经验和模板能减少无脸视频的创建时间,因为它们用已批准的默认选项取代了重复的选择。经验丰富的创作者不会从头开始决定视频的开头、字幕的样式、场景如何变换或号召性用语的声音。Stitchr 估计,创作者可以将无脸视频从首次尝试的 6-12 小时 减少到 2-3 小时,随着流程熟悉 在其基准中。
为每个上传中反复出现的决策建立模板:
- 一个包含受众、承诺、角度和来源字段的主题简报。
- 针对不同视频类型的两到三个脚本结构。
- 一个包含可读行长度和位置的字幕预设。
- 一套视觉规则,规定场景时长、镜头风格和转场效果。
- 一个最终的质量控制清单。
模板应创造一致性,而不是强制相同。在保持制作框架稳定的同时,更改声明、示例、引子和视觉证据。这种平衡保护了速度,而不让每个上传感觉像是抄袭。
一个有用的起点是按阶段记录接下来五个视频的制作时间。进度最慢的阶段是值得构建的第一个模板。如果视觉选择占据了大部分时间表,则应创建一个视觉库。如果开场耗时过长,则存储行之有效的结构并进行明确测试。
什么是自动化管道,如何帮助?
自动化管道是一个连接的制作序列,可以将主题或简报带入脚本创建、配音、视觉、字幕、组装和导出,减少手动交接。自动化的无脸视频管道能够在大约 20 分钟 内制作视频,只要格式已准备好,而系统化的经验丰富工作流程大约需要 2 小时 根据引用的制作基准 和工作流程指南。
该管道不需要完全无人干预。最强的版本具有定义的人类检查点:批准主题角度、审核脚本声明、检查视觉相关性,并作为观众观看导出视频。自动化负责组装;创作者则控制标准。
一个好的自动化管道具备三大特性:
输入结构化: 每个简报都包括受众、目标、格式、期望时长和来源限制。
输出可重用: 该过程创建可重复的叙述、视觉、字幕和导出格式。
审核有限但刻意: 创作者仅检查高风险决策,而不是手动重建整个视频。
欲了解更深入的操作模型,请使用围绕两小时系统构建的 AI 视频制作工作流程。目标不是零努力,目标是将努力集中在提升质量的地方。
有哪些关于 AI 在视频创作中应用的现实世界例子?
关于无脸视频创作中 AI 的现实世界应用通常表现为实际的分工:AI 草拟脚本、生成配音、提出或生成视觉、创建字幕并组装初剪;创作者则选择主题、检查声明、细化节奏并批准最终导出。最清晰的基准是 Stitchr 报告的路径,从 6-12 小时 的第一部视频到 2-3 小时 的熟悉工作,以及借助自动化的约 20 分钟。
短视频创作者可能会将一个问题融入可重复的解释器格式,审核前两行的清晰度,替换任何薄弱的场景匹配,然后在最终音效和字幕检查后发布。一位教育创作者可能会利用 AI 制作初稿故事板,但会花更多时间验证示例并使得顺序易于教授。
最值得借鉴的例子不是“按生成并发布”。而是“标准化格式,自动化可重复劳动,并保持对观众决策的审批”。这种方法创造了一个可衡量和改进的生产系统。
我该如何提高制作速度?
通过测量每个阶段、简化格式、将类似工作分批处理以及只审核影响准确性或保持观众的决策,你可以提高无脸视频制作速度。目标不是最快的导出,而是一个可重复的流程,达到 2-3 小时的经验范围 或当格式支持时的自动化 20 分钟 工作流程 根据 Stitchr。
从每周的制作审核开始。记录在主题选择、研究、编剧、视觉、配音、编辑、字幕和质量控制上消耗的分钟数。然后逐一消除瓶颈。不要同时更改所有工具和格式,否则你无法知道究竟是什么改善了进度。
行动: 首先批量处理主题和研究,然后是脚本,最后是最终审查。情境切换通常比单独任务更慢。
行动: 使用固定的运行时间范围。稳定的时长让脚本长度、场景数量和审查时间更容易预测。
行动: 在撰写主体前先写引子。清晰的开头能防止脚本后期大幅重写;使用 经过验证的视频引子库 更快生成开场角度。
行动: 保持短小的质量控制清单,涵盖事实准确性、语音发音、字幕时机、视觉相关性和导出格式。
常见误解: 更快的输出并不意味着发布更多未完成的草稿。当第一轮剪辑后需要重建的视频更少时,制作速度将会得到提升。
准备好将可重复的简报转化为更快的工作流程了吗?
GoFaceless(我们的产品)是将主题、简报或参考转化为成品短视频的一种方式,涵盖了脚本、配音、视觉、字幕、音乐、预览和导出控制。如果你的格式已经定义,你可以 开始创建无脸视频,并将最终审核集中在准确性、节奏和观众价值上。